Tři nebo čtyři Sparks.
DeepSeek připravený na víc.
Vlastní EXL3 váhy DeepSeek 1017, TensorFold a dvě přesně popsané sestavy. Recept TP3 1.2.8 zrychluje zpracování dlouhých zadání na třech strojích. Nový TP4 4.0.0 využívá čtyři DGX Sparks, větší KV pool a prostor pro více souběžných požadavků.
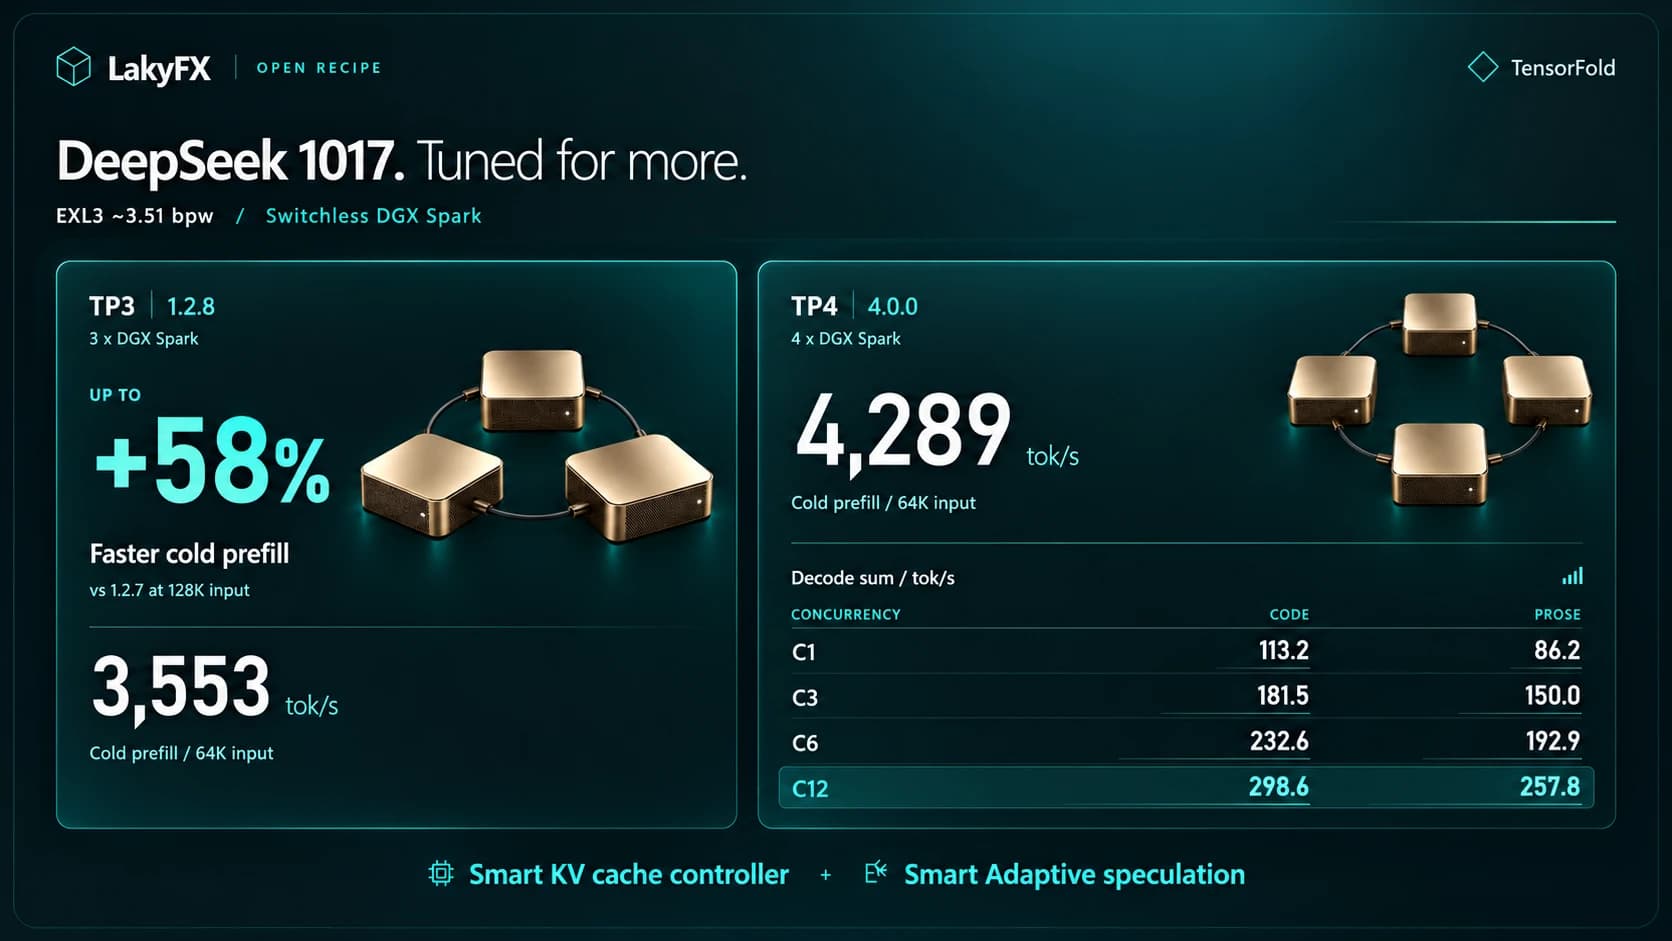
Rychlejší cold prefill v TP3
Vstup 128K, recept 1.2.8 oproti 1.2.7. Medián tří měření bez zásahů cache.
Cold prefill v TP4 při 64K
Medián vybrané výpočetní cesty P2, kterou finální 4.0.0 zachovává.
Součet dekódování kódu při C12
Krátký TP4 test, zahřátý druhý průchod, thinking OFF, bez prefillu.
Dokončený agentní workflow
Finální TP4 profil P3: 327 požadavků a 15,14 minuty součtu časů vln.
Méně zbytečných výpočtů. Více prostoru pro práci.
Chytrá KV cache
Smart KV cache controller řídí uchovávání a opětovné využití prefixů. Průběžně vyhodnocuje návraty požadavků i cenu přepočtu. Agent tak může lépe navazovat na rozpracovanou konverzaci nebo opakované zadání.
Adaptivní spekulace
Smart Adaptive speculation přizpůsobuje návrhy dalších tokenů skutečné zátěži a úspěšnosti jejich ověřování. Rozhoduje podle nákladů inference za běhu, bez dalšího trénování vah modelu.
Výpočty rozdělené mezi uzly
Při zpracování vstupu dělíme skutečnou práci mezi stroje. Ladíme výpočetní bloky, promptové kernely a plánování Engramu. Oba recepty fungují v přímém propojení RoCE bez síťového switche.
KV cache uchovává výpočty pro opakované vstupy. Pro dlouhodobé znalosti projektu napříč agenty a harnessy používáme sdílenou persistentní paměť CogniLayer. Při měřeních cold prefillu níže bylo využití cache nulové.
Dlouhé zadání zpracované rychleji.
Na stejných třech DGX Sparks a stejných vahách jsme při vstupech 32K až 128K naměřili zrychlení cold prefillu o 51 až 58 % oproti 1.2.7. Při 64K vstupu dosahuje nový recept mediánu 3 552,8 tok/s. Nejvyšší relativní zlepšení patří vstupu 128K.
| Délka vstupu | 1.2.7 | 1.2.8 | Zrychlení |
|---|---|---|---|
| 1K | 1 511,1 | 1 826,5 | +20,9 % |
| 2K | 1 816,6 | 2 366,6 | +30,3 % |
| 4K | 2 027,4 | 2 801,3 | +38,2 % |
| 8K | 2 207,2 | 3 169,1 | +43,6 % |
| 32K | 2 330,6 | 3 525,2 | +51,3 % |
| 64K | 2 310,9 | 3 552,8 | +53,7 % |
| 128K | 2 215,8 | 3 499,2 | +57,9 % |
K znamená 1 024 tokenů. Stejné předem připravené vstupy, thinking OFF, teplota 0 a žádné tokeny převzaté z KV cache. Model byl načtený; test neměřil start ze studeného disku. Jde o rychlost výpočtu vstupu, nikoli rychlost dekódování nebo celkový čas do prvního tokenu. Pro 1.2.8 tím nepublikujeme nové měření dekódování.
Čtvrtý Spark. Více možností pro celý tým.
TP4 přenáší naši práci na čtyři uzly v přímém kruhovém propojení. Finální profil 4.0.0 má nastavenou kapacitu C16, fyzický KV pool 9M tokenů a kontext až 401 408 tokenů. Chytrá cache i adaptivní spekulace zůstávají součástí receptu.
| Souběžné požadavky | Kód | Souvislý text |
|---|---|---|
| C1 | 113,2 | 86,2 |
| C3 | 181,5 | 150,0 |
| C6 | 232,6 | 192,9 |
| C12 | 298,6 | 257,8 |
Zahřátý druhý průchod, thinking OFF, greedy a 512 výstupních tokenů na požadavek. Čísla jsou součtem rychlostí jednotlivých požadavků bez prefillu. Nejde o okamžitou špičku sestavy ani propustnost celého workflow. Při C12 vychází zvlášť měřená propustnost celé vlny včetně přípravy a doběhů na 263,73 tok/s pro kód a 237,12 tok/s pro text.
Krátký test i cold prefill 4 289,3 tok/s při 64K byly naměřeny na vybrané cestě P2 s kapacitou C12, KV poolem 7M a checkpointy 3 GiB. Finální profil P3 ve verzi 4.0.0 zachovává tuto výpočetní cestu, ale zvyšuje kapacitu na C16 / 9M / 3,5 GiB. Po tomto zvýšení nebyla tato dvě měření zopakována a skóre krátkého testu pro C16 neuvádíme.
Agent má úkol dokončit.
Na finálním TP4 profilu jsme samostatně ověřili připravenou sadu agentních úloh se skutečnými nástroji, testy a opravami. Se zapnutým MAX reasoningem systém dokončil všech 78 úloh při souběhu od C1 po C12.
| Měření | Výsledek |
|---|---|
| Správně dokončené úlohy | 78/78 |
| Modelové požadavky | 327 |
| Součet časů testovacích vln | 908,31 s · přibližně 15,14 min |
| Opravitelné chyby nástrojů | 12 |
| Opakování inference kvůli selhání | 0 |
| Podmínky | MAX reasoning ON · teplota 0,6 · C1 až C12 |
Opravitelné chyby nástrojů zůstávají započítané. Výsledek jedné testovací kampaně neznamená stejnou úspěšnost každého produkčního zadání. Kapacita C16 prošla odděleným funkčním testem; sada 78 úloh byla měřena do C12. Tyto výsledky mají jiný protokol než krátký test dekódování i starší měření SparkDash.
Vyberte recept podle svého hardwaru.
| Nastavení | TP3 | TP4 |
|---|---|---|
| Počet DGX Spark | 3 · TP3 | 4 · TP4 |
| Recept | 1.2.8 | 4.0.0 |
| Nastavená kapacita souběhu | C12 | C16 |
| Fyzický KV pool | 7M tokenů | 9M tokenů |
| Paměť pro checkpointy na hlavním uzlu | 3 GiB | 3,5 GiB |
| Výpočetní blok prefillu | 4K tokenů | 8K tokenů |
| Maximální kontext modelu | 401 408 tokenů | 401 408 tokenů |
Obě varianty používají vlastní smíšené EXL3 váhy s přibližně 3,51 bpw u routovaných expertů. TP4 připravuje jejich přesné rozdělení pro čtyři uzly bez změny kvantizace. Čísla C12 a C16 označují nastavený počet souběžných slotů, nikoli příslib rychlosti každého požadavku.
Co má vaše lokální AI zvládnout?
Navrhneme sestavu podle vašich dat a skutečné práce. Od zpracování dlouhých dokumentů po agentní tým se sdílenou persistentní pamětí.