Stejné tři stroje.
Více hotové práce.
DeepSeek V4.1 Flash 1017 na třech DGX Sparks posouváme dál. Hlavní recept 1.2.4 s TensorFoldem přizpůsobuje spekulativní dekódování aktuální zátěži. V našem srovnávacím testu dokončil stejnou sadu 78 úloh za 19 minut a 14 sekund místo původních 22 minut a 28 sekund.
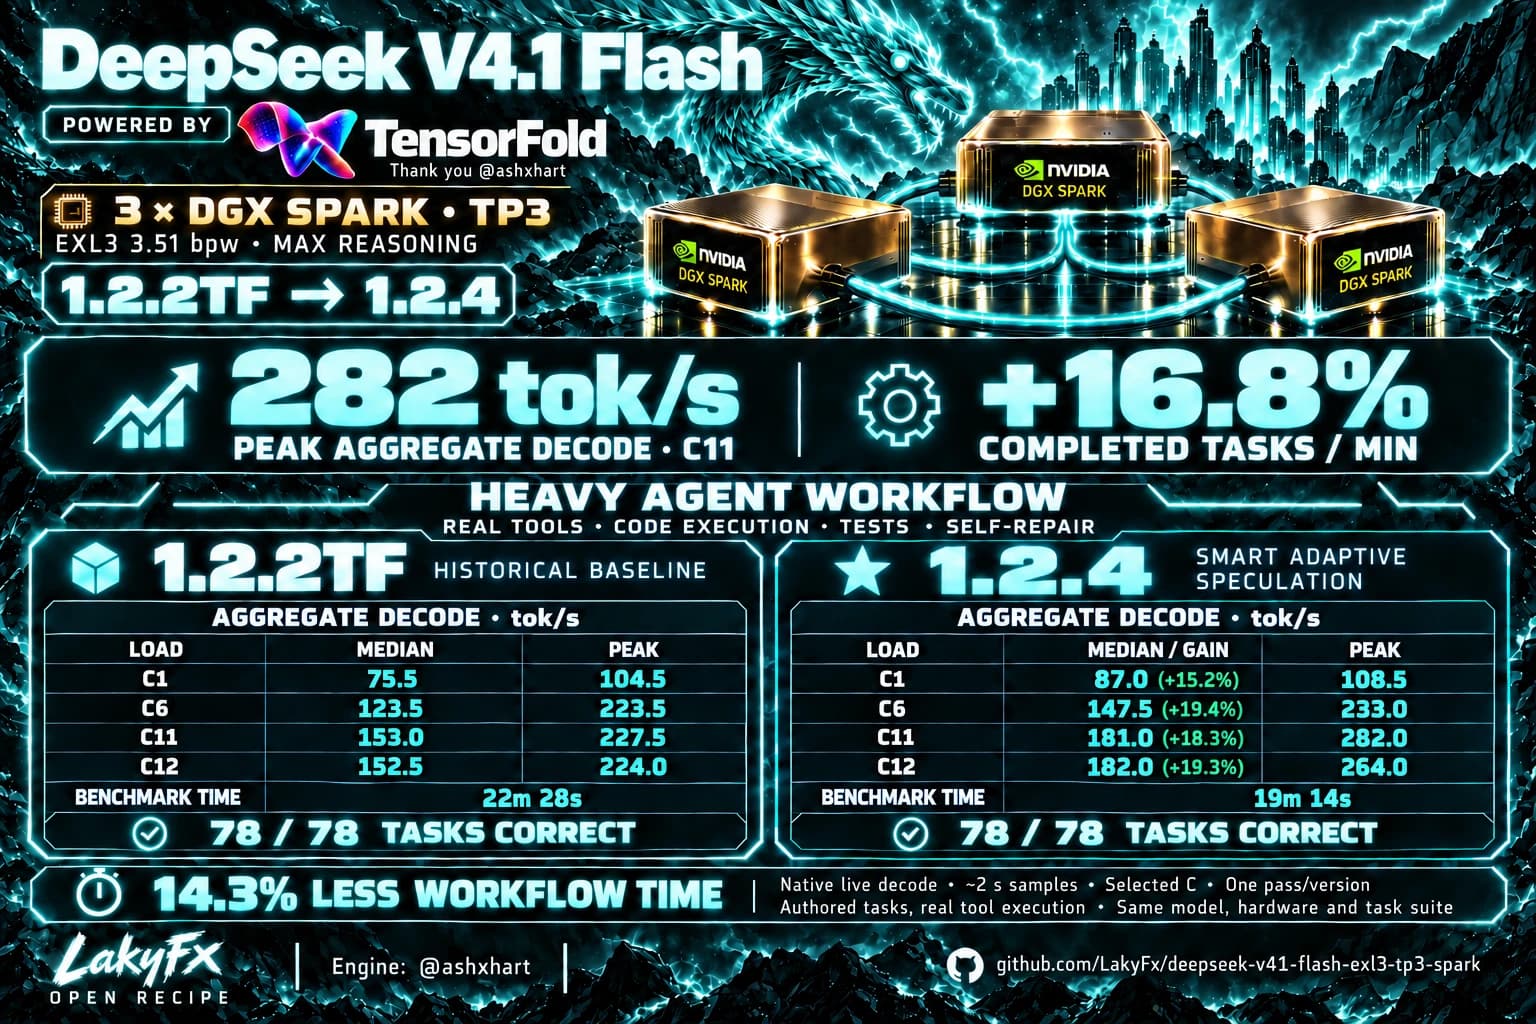
Více hotových úloh za minutu
Správně dokončené úlohy vůči celkovému času testu, oproti 1.2.2TF.
Kratší čas celého workflow
Zahrnuje prefill, nástroje, testy, opravy i čekání.
Úspěšně dokončeno
Stejný výsledek u obou porovnávaných verzí.
Pozorovaná špička při C11
Krátká hodnota souhrnného dekódování, nikoli průměr celého běhu.
Inference, která reaguje na zátěž.
Při spekulativním dekódování vznikají návrhy dalších tokenů, které hlavní model následně ověřuje. Recept 1.2.4 sleduje skutečné náklady ověřování i úspěšnost návrhů a podle průběhu práce upravuje, kolik spekulace se vyplatí. Sdílený rozpočet přizpůsobuje souběžným požadavkům.
Počítá s reálnými náklady.
Rozhodování vychází z práce, kterou ověřování skutečně vykoná. Recept omezuje kroky, které aktuální cesta nemůže využít.
Využívá čas CPU i GPU.
Přípravu části výpočtů na CPU překrývá s prací GPU. Náklady průběžného měření drží pod kontrolou a obnovuje zastaralé odhady.
Dává prostor běžícím úlohám.
Mezi přijímáním nových požadavků nechává pokračovat také rozpracované výstupy. Ladíme tak chování celé sestavy při souběžné práci.
Adaptace probíhá za běhu inference a její stav patří běžícímu procesu. Nejde o další trénování vah modelu; po restartu se tento stav neuchovává. Konkrétní nastavení a implementaci zveřejňujeme v receptu.
Stejná sada úloh. Kratší čekání na výsledek.
Agentní práce zahrnuje víc než samotné generování odpovědi. Proto porovnáváme i celý čas testu se skutečným vykonáváním nástrojů, kódu, testů a opravných kroků. Rychlost dokončené práce vychází z počtu správných úloh a celkového času.
| Měření | 1.2.2TF | 1.2.4 |
|---|---|---|
| Celkový čas | 22 min 28 s | 19 min 14 s |
| Správně dokončené úlohy | 78/78 | 78/78 |
| Úlohy za minutu oproti 1.2.2TF | Výchozí stav | +16,8 % |
| Celkový čas oproti 1.2.2TF | Výchozí stav | −14,3 % |
Jde o jeden pozorovaný průchod na verzi. Sada obsahuje připravená zadání, nikoli nezměněný záznam produkčních relací. Výstupy i cesty oprav se mezi běhy liší. Výsledek popisuje tuto konkrétní kampaň a sám o sobě neprokazuje vyšší kvalitu odpovědí ani stejné zrychlení každé úlohy.
Souběh od C1 po C12.
Následující hodnoty ukazují souhrnný výstup aktivních požadavků v úsecích, kdy model dekóduje. C označuje počet současně aktivních modelových požadavků. Mediány lépe popisují běžné hodnoty v těchto úsecích než samotná nejvyšší špička.
| Aktivní požadavky | 1.2.2TF | 1.2.4 | Změna mediánu |
|---|---|---|---|
| C1 | 75,5 | 87,0 | +15,2 % |
| C6 | 123,5 | 147,5 | +19,4 % |
| C11 | 153,0 | 181,0 | +18,3 % |
| C12 | 152,5 | 182,0 | +19,3 % |
Krátce pozorované špičky.
| Aktivní požadavky | 1.2.2TF | 1.2.4 |
|---|---|---|
| C1 | 104,5 | 108,5 |
| C6 | 223,5 | 233,0 |
| C11 | 227,5 | 282,0 |
| C12 | 224,0 | 264,0 |
Živé hodnoty byly vzorkovány přibližně po dvou sekundách, při přesně daném počtu aktivních požadavků uvnitř odpovídající testovací vlny. Krátká špička 282 tok/s při C11 není trvalá rychlost ani průměr celého workflow. Mediány zohledňují délku jednotlivých intervalů; tato část pohledu nezahrnuje úseky se samotným prefillem, nástroji ani doběhy s nižším souběhem. Krátké pokrytí některých úseků je vyznačené v původních podkladech.
Celý postup je veřejný.
Recept 1.2.4 používá DeepSeek 1017 s EXL3 experty přibližně 3,51 bpw, TensorFold a tři DGX Sparks v TP3. V repozitáři najdete nastavení, zdrojové úpravy, úplnou matici čtrnácti variant i podklady pro ověření měření. Pro vlastní zátěž si můžete vybrat podle skutečných kompromisů mezi rychlostí jednotlivých požadavků a časem celého úkolu.
Co má vaše lokální AI zvládnout?
Pomůžeme s nasazením a optimalizací podle vašeho hardwaru, dat a skutečné zátěže. Od dlouhého kontextu až po tým agentů se sdílenou persistentní pamětí.