Tři stroje. Dvanáct požadavků.
DeepSeek s TensorFoldem v číslech.
Lokální AI musí zvládnout víc než jediný dotaz. Na třech DGX Sparks jsme proto změřili, jak náš recept DS41F 1.1.0TF pracuje při rostoucím souběhu a jak rychle zpracuje dlouhé vstupy. Při dvanácti souběžných požadavcích dosáhl ve smíšeném testu průměrné souhrnné propustnosti 170,5 tokenu za sekundu.
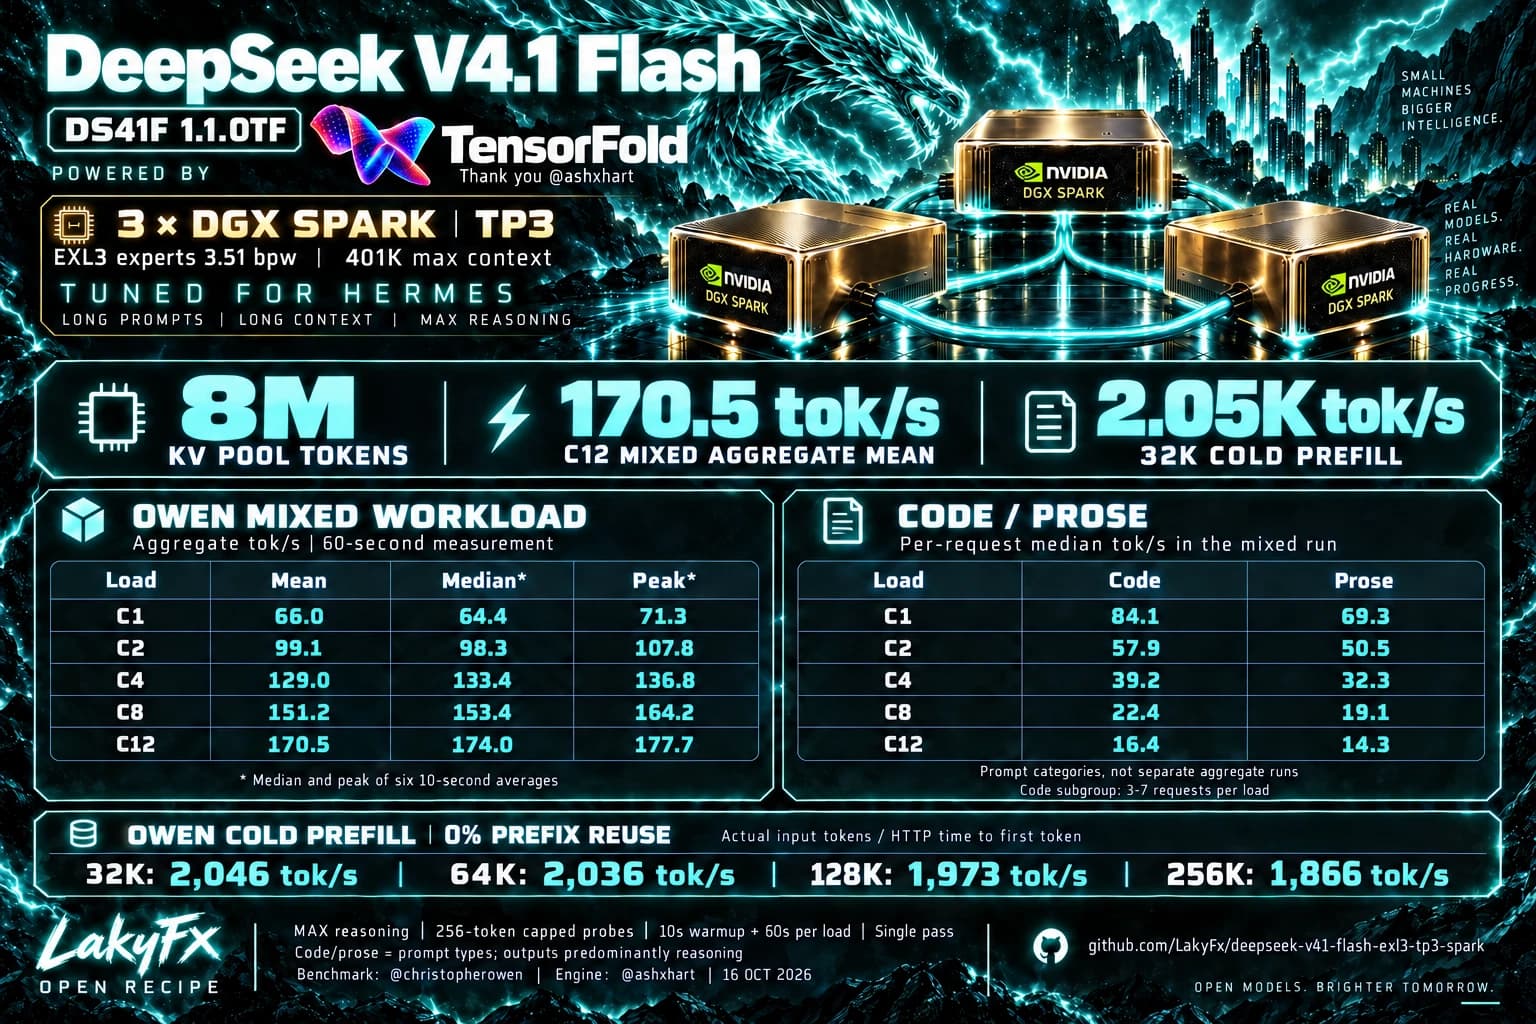
Sdílený KV pool
Celková kapacita cache sdílená mezi požadavky.
Maximální kontext
Až 401 408 tokenů v jednom požadavku včetně odpovědi.
Souhrnný výkon při C12
Průměr všech souběžných požadavků během měřené minuty.
Studený prefill 32K
Vstupní tokeny dělené časem do prvního tokenu odpovědi.
Více požadavků. Vyšší celková propustnost.
Od jednoho po dvanáct souběžných požadavků roste průměrný společný výstup z 66,0 na 170,5 tok/s. Pro tým agentů je to užitečný pohled na kapacitu celé sestavy. S vyšším souběhem se ale výkon dělí mezi více požadavků, takže jednotlivá odpověď může přicházet pomaleji.
| Souběh | Průměr | Medián intervalů | Nejvyšší interval |
|---|---|---|---|
| C1 | 66,0 | 64,4 | 71,3 |
| C2 | 99,1 | 98,3 | 107,8 |
| C4 | 129,0 | 133,4 | 136,8 |
| C8 | 151,2 | 153,4 | 164,2 |
| C12 | 170,5 | 174,0 | 177,7 |
C1 až C12 označuje počet souběžných požadavků. Každé úrovni předcházelo 10 sekund zahřívání, následovalo 60 sekund měření v jednom průchodu. Medián a nejvyšší hodnota vycházejí ze šesti přibližně desetisekundových intervalů. Nejvyšší interval není okamžitá špička.
Dva typy zadání ve stejném běhu.
Ze smíšeného testu jsme oddělili požadavky se zadáním pro Python a SQL a požadavky s přirozeným jazykem. Tabulka ukazuje medián rychlosti jednotlivých požadavků. Nejde o dva samostatné testy celkové propustnosti.
| Souběh | Kód | Text |
|---|---|---|
| C1 | 84,1 | 69,3 |
| C2 | 57,9 | 50,5 |
| C4 | 39,2 | 32,3 |
| C8 | 22,4 | 19,1 |
| C12 | 16,4 | 14,3 |
Vzorek pro kód obsahuje jen 3 až 7 odpovědí na úroveň souběhu. Názvy kategorií popisují zadání, nikoli hotový výsledek: režim MAX reasoning měl limit 256 výstupních tokenů a výstup tvořilo převážně uvažování. Všechny odpovědi skončily na délkovém limitu. Tento test měří propustnost, nikoli kvalitu či dokončení úlohy. Medián na požadavek nelze násobit souběhem a vydávat za samostatně naměřený výkon kódu nebo textu.
Od 32K až po 256K tokenů.
Dlouhé zadání je běžná součást práce agentů. Změřili jsme proto i první zpracování vstupu bez opětovného využití prefixu. I při vstupu kolem 256 tisíc tokenů dosahuje sestava přibližně 1 866 tok/s.
| Vstup | Skutečné tokeny | Čas do prvního tokenu (s) | Prefill (tok/s) |
|---|---|---|---|
| 32K | 32 796 | 16,031 | 2 046 |
| 64K | 65 540 | 32,187 | 2 036 |
| 128K | 131 081 | 66,453 | 1 973 |
| 256K | 262 169 | 140,531 | 1 866 |
Rychlosti jsou zaokrouhlené na celé tok/s stejně jako v obrázku. Studený prefill znamená nulové opětovné využití prefix KV cache, nikoli vymazání systémových či Engram cache. Korpus používá dokumenty ze zdrojů Pythonu pro Windows podle Owenovy metody; není bajtově totožný s jeho linuxovým korpusem.
Recept vyladěný pro naši práci.
- Verze
- DS41F 1.1.0TF · před modelem 1017
- Hardware
- 3× NVIDIA DGX Spark · TP3
- Engine
- TensorFold
- Experti
- EXL3 · 3,51 bpw
- KV pool / max. kontext
- 8M / 401 408 tokenů
- Nastavení
- S12/R32 · 2 GiB stavu na rank
- Takt GPU
- Limit 2 200 MHz
Otevřená čísla. Jasné hranice.
Jde o jeden zkrácený průchod Owen benchmarku, nikoli dlouhodobý průměr z produkce. Různé testy popisují různé části práce. Se starším měřením C4 je nelze přímo porovnat jako zaručené zrychlení, protože se liší konfigurace i metodika. Výsledky také nepřenášíme na nové váhy 1017.
Co má vaše lokální AI zvládnout?
Pomůžeme s nasazením a optimalizací podle vašeho hardwaru, dat a skutečné zátěže. Od dlouhého kontextu až po tým agentů se sdílenou persistentní pamětí.