Dlouhé zadání. Plný kontext.
Agent pracuje s rozsáhlými podklady, historií úkolu a výsledky nástrojů. Proto ladíme zpracování dlouhých vstupů i kapacitu kontextu pro pokračující práci.
Vlastní TP3 recept pro DeepSeek V4.1 Flash. Dlouhá zadání, opakované využití prefix cache a MAX reasoning. Tak, jak lokální AI používáme každý den s Hermes Agentem.
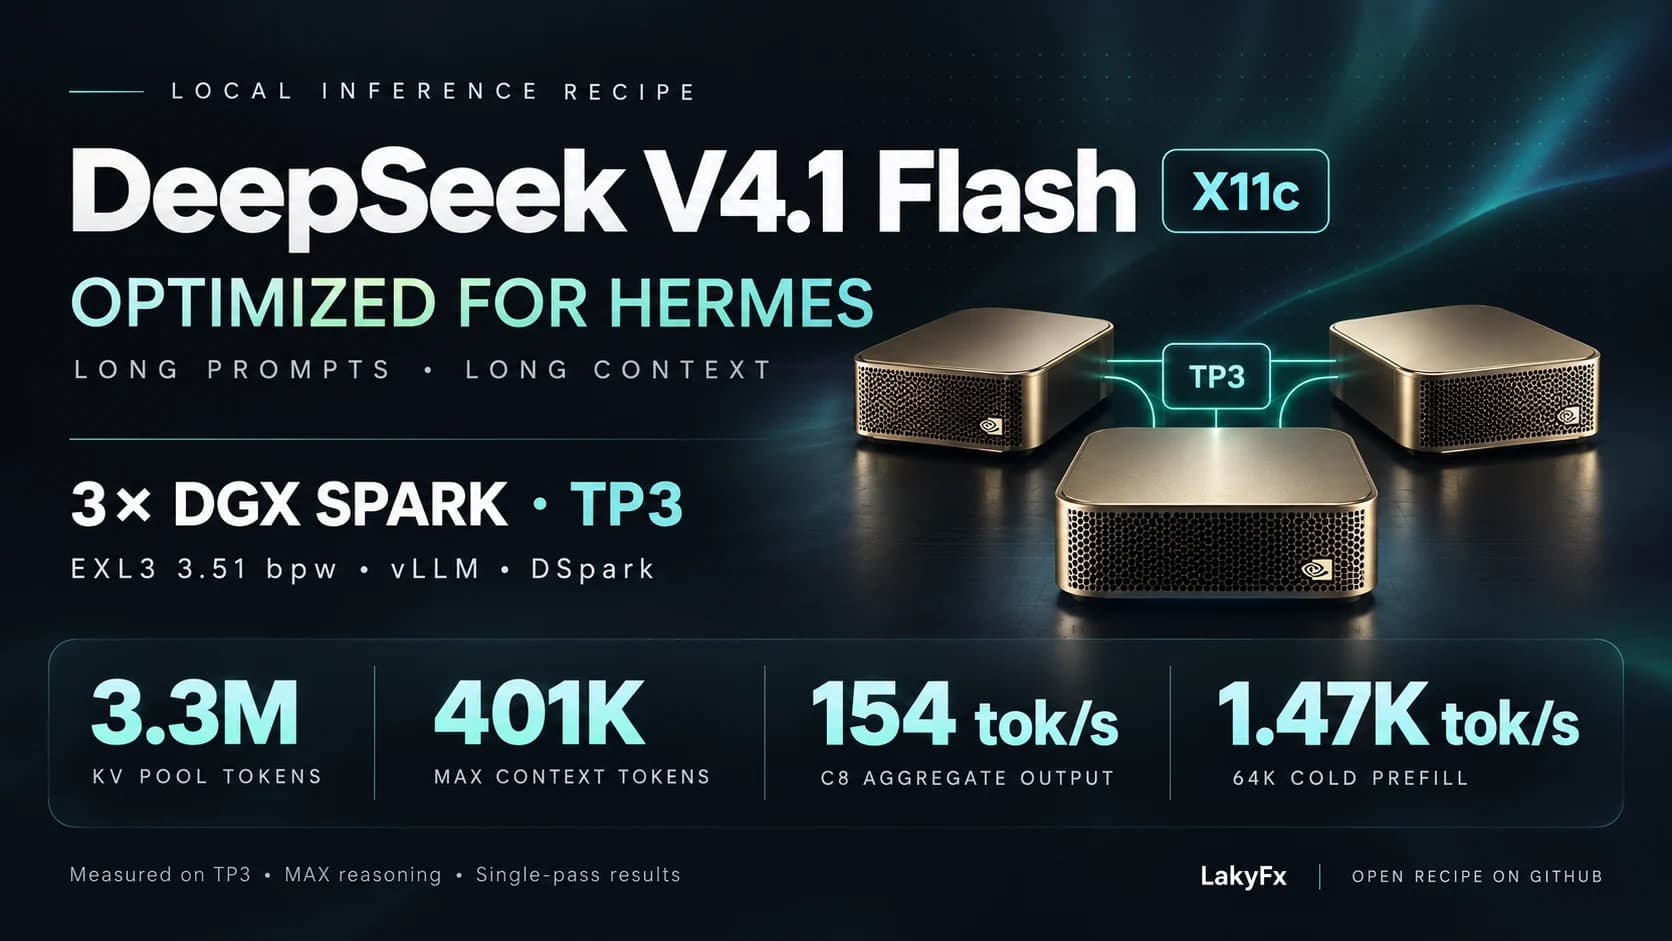
Naměřená kapacita pro opakované využití kontextu napříč požadavky.
Až 401 408 tokenů v jednom požadavku, včetně generované odpovědi.
154,38 tok/s celkem při osmi souběžných požadavcích, včetně čekání na první token.
1 467,88 tok/s při zpracování dlouhého vstupu bez již zahřáté cache.
Měření konfigurace X11c v režimu MAX reasoning. Kapacita KV cache je sdílená mezi požadavky; maximální kontext zahrnuje vstup i odpověď. Údaj C8 vyjadřuje souhrnný výkon osmi požadavků.
Recept jsme začali ladit, protože jiné konfigurace neodpovídaly našemu způsobu práce. Prioritou byl dlouhý kontext, velké vstupy, opakované využití cache a přemýšlení v režimu MAX. Výsledkem je nastavení, které používáme v našem agentním provozu.
Agent pracuje s rozsáhlými podklady, historií úkolu a výsledky nástrojů. Proto ladíme zpracování dlouhých vstupů i kapacitu kontextu pro pokračující práci.
Opakované části zadání patří do prefix cache. Konfiguraci jsme ladili pro práci, kde se agent vrací ke stejnému základu a přidává nové kroky, místo aby pokaždé začínal od nuly.
Hlavní Hermes Agent běží v režimu MAX reasoning. Recept vznikal při skutečné agentní práci s nástroji a souběžnými požadavky, které potřebují prostor i průběžný kontext.
Tři stroje spolu zpracovávají model pomocí tensor parallelismu. Recept propojuje inference engine, kvantizované váhy, cache a spekulativní dekódování do ověřené sestavy.
| Měření | Výsledek |
|---|---|
| C1: dekódování jednoho požadavku | 67,50 tok/s |
| C3: dekódování na požadavek | 32,12 tok/s |
| C8: souhrnný výstup | 154,38 tok/s |
| 64K: studený prefill | 1 467,88 tok/s |
C1 a C3 měří dekódování na požadavek. C8 měří celkový výstup vůči době běhu skupiny, včetně latence prvního tokenu. Tyto hodnoty nelze přímo porovnávat jako jednu křivku škálování.
Jde o jednotlivé běhy v konkrétním prostředí. Testy 128K při C3 narazily na časový limit a neposkytly dokončený výsledek. Metodika, další běhy i omezení jsou dostupné v repozitáři.
Pomůžeme s nasazením a optimalizací modelů podle vašich dat, hardware a způsobu práce. Od dlouhého kontextu a RAG po celý tým agentů se sdílenou persistentní pamětí.